01
审校闸门
知识条目没通过人工审校,脚本生成这一步就进不去。
Open source · Runs locally · Sources on the page
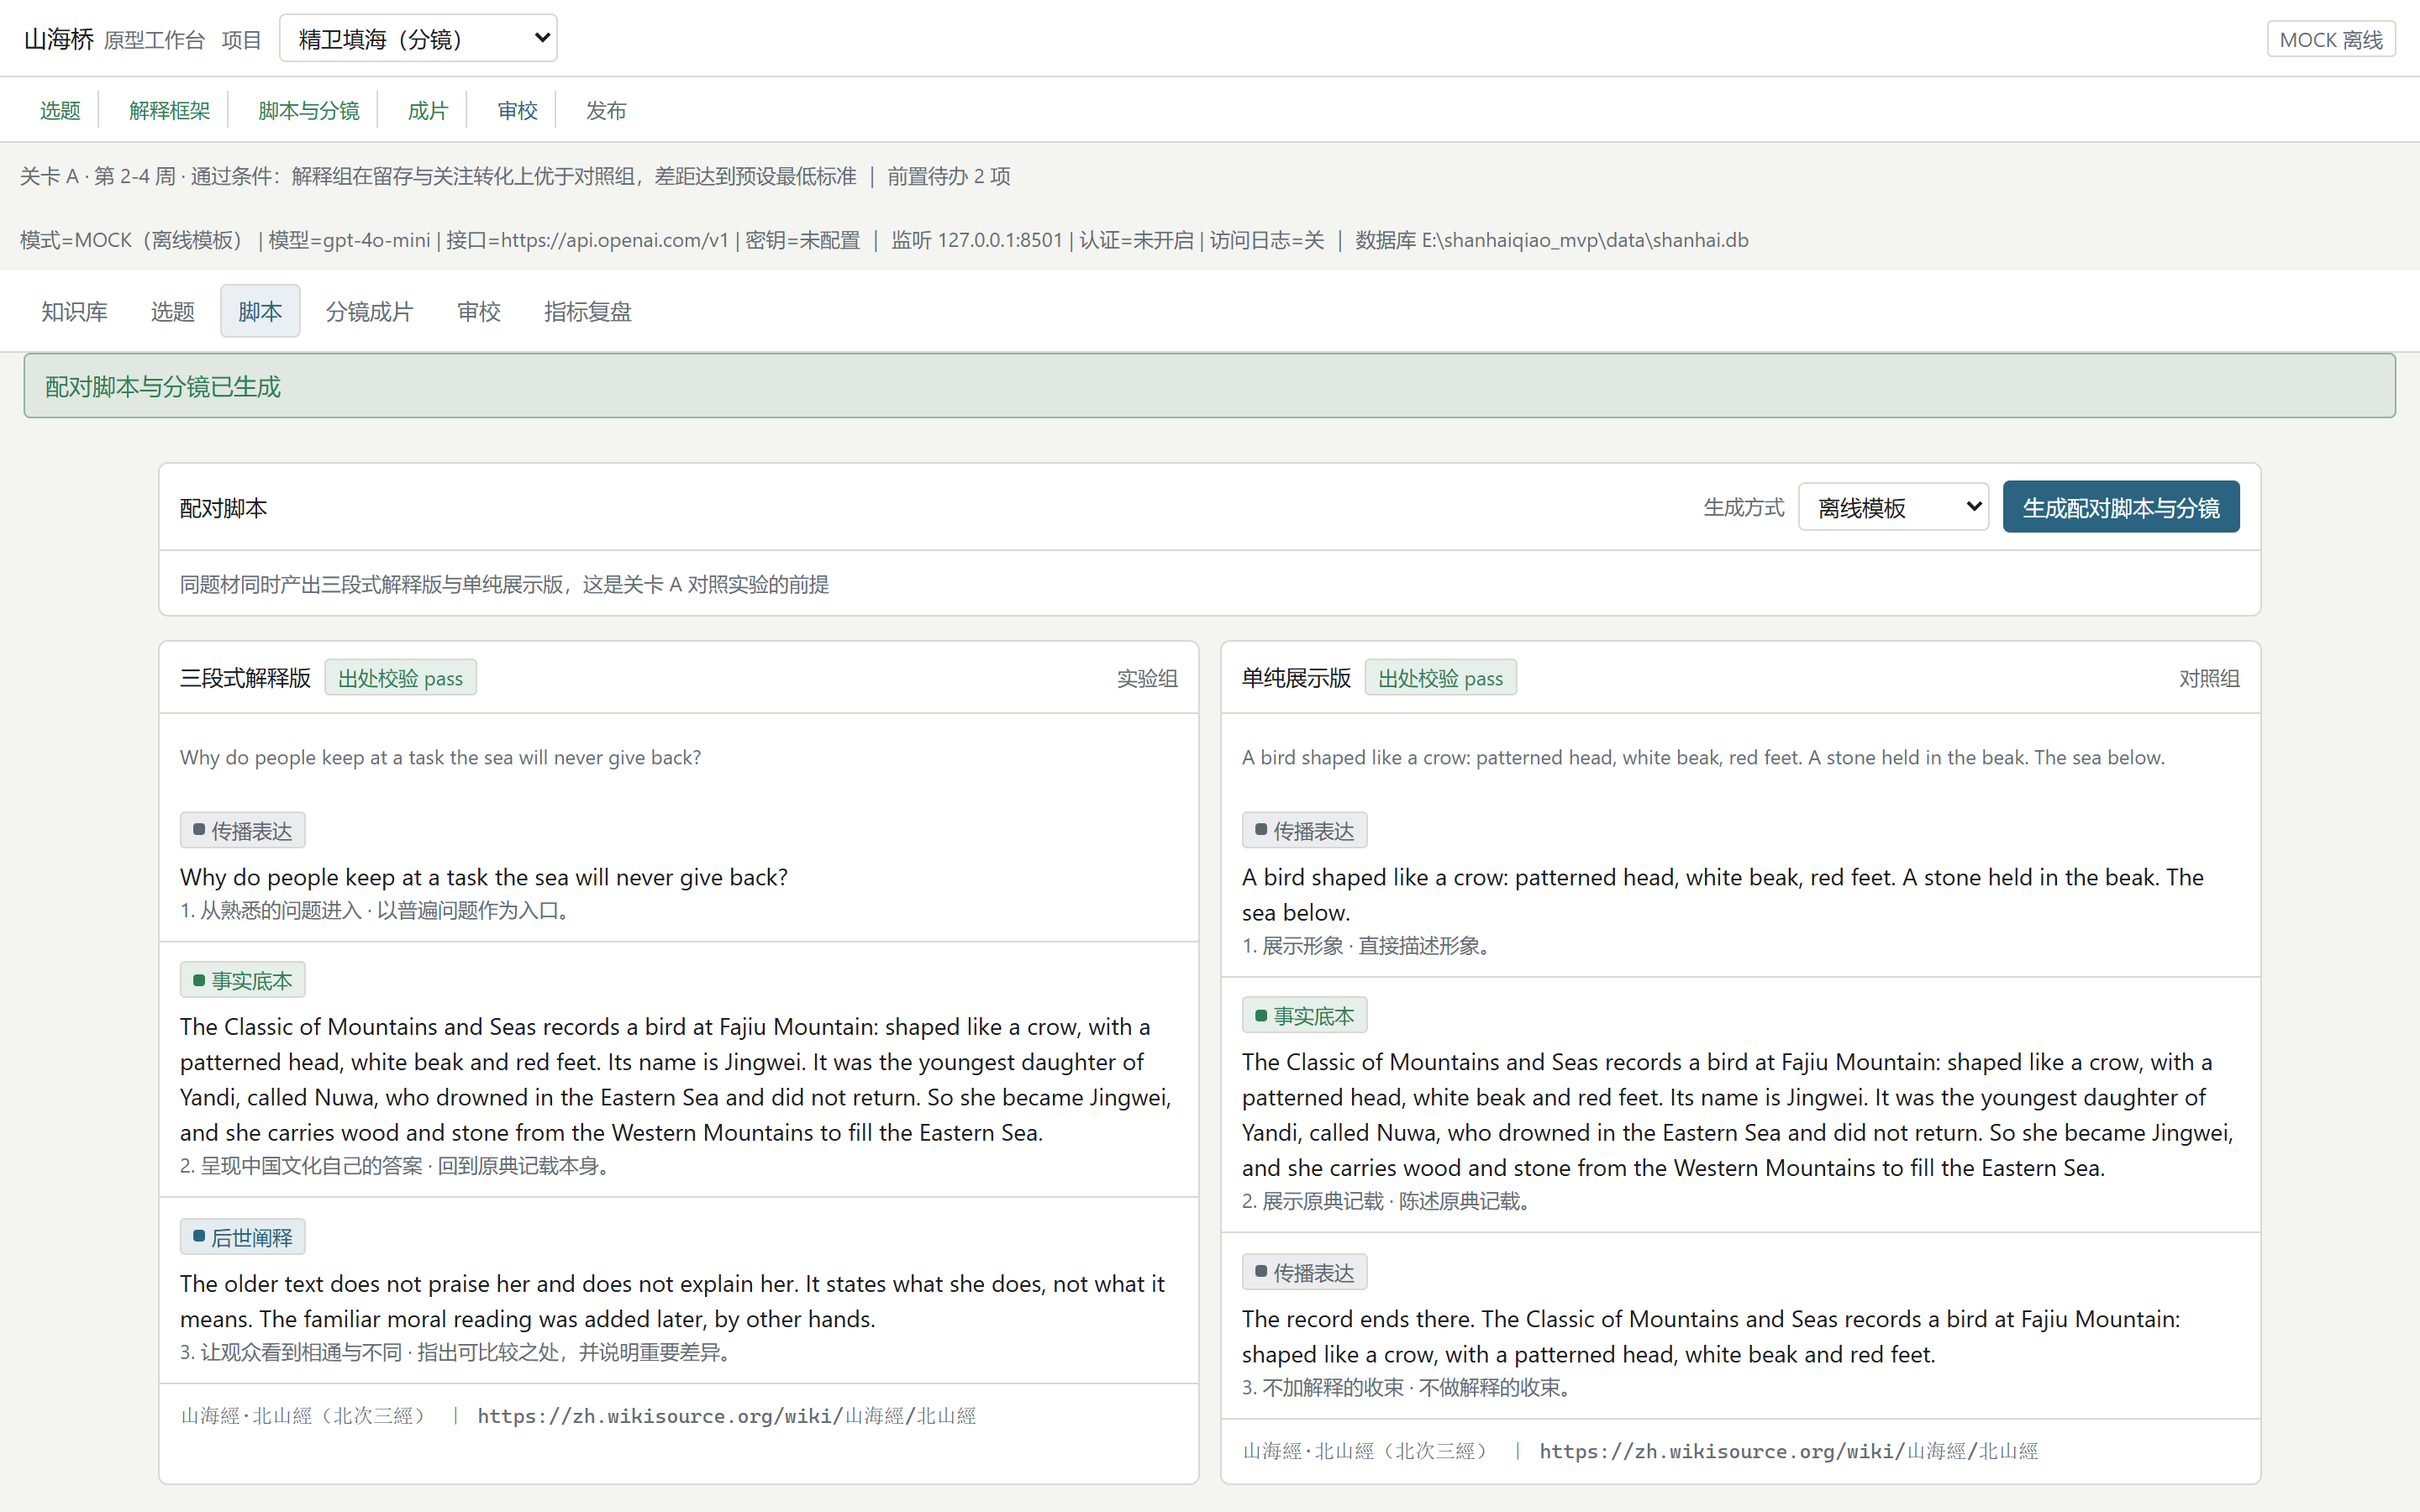
《山海经》条目进去,双语脚本、分镜和一条可播放的短片出来。每一句是原典、后世解释还是改编,都标在画面上——出处缺失时,生成直接中止。
Two ways to run
网页端用来快速看效果,客户端用来真正干活。两边跑的是同一套闸门和版式,不会出现"演示好看、实际不一样"。
Python 直接运行,SQLite 存项目,FFmpeg 合成 1280×720 的 MP4 与 SRT。数据不出本机。
What it does
01
知识条目没通过人工审校,脚本生成这一步就进不去。
02
任何一段文化陈述缺少可追溯链接,生成链路直接中止。
03
同题材一次产出解释版与展示版,供对照实验使用。
04
标题、原典、阐释、对照、片尾,按数据层次自动选择。
05
观察窗口未满只输出「未满」,基准没填就不产生任何判定。
06
项目、脚本、分镜、审校与指标,一个 JSON 带走。
Install
下载的是可运行的源码包,不是安装器。解压后直接跑,不需要编译,也不需要 GPU。
# 解压后进入目录
unzip shanhaiqiao_mvp-0.3.0.zip
cd shanhaiqiao_mvp

# 先查环境:FFmpeg、中文字体、目录权限、端口
python run.py --check

# 启动,浏览器打开 http://127.0.0.1:8501
python run.py
Why trust it
产品方案里定下三条硬性规则,落到代码里是可执行的中止条件,不是宣传语。
原典原文逐字录入,带书名、篇名、版本说明与链接。缺链接不上线。
成语化的寓意、道德评价单独成层,标注为后世解释,不与原文混写。
角色外观与情节中属于改编的部分必须写明改编了什么,否则生成中止。
FAQ
不需要。默认使用离线模板,全部功能可跑通。只有当你希望脚本由真实模型撰写时,才需要配置兼容 OpenAI 接口的密钥,且密钥只从环境变量读取,不落库。
客户端存在项目目录下的 data/shanhai.db,成片在 out/;网页版存在浏览器本地存储。两处都不经过我的服务器。
网页版把全部逻辑放在浏览器里,适合试用与演示,画面以 HTML 实时渲染;客户端多两样东西——SQLite 持久化和 FFmpeg 合成,能真正导出 MP4 与 SRT。
目前是 0.3.0 原型,优先保证可审查、可修改。打包成双击安装的程序会掩盖它的实现细节,也不利于你核对规则到底有没有被强制执行。